


Des best-sellers aux radiations, le géant de l'édition tire le premier coup de feu dans la campagne "anti-IA"
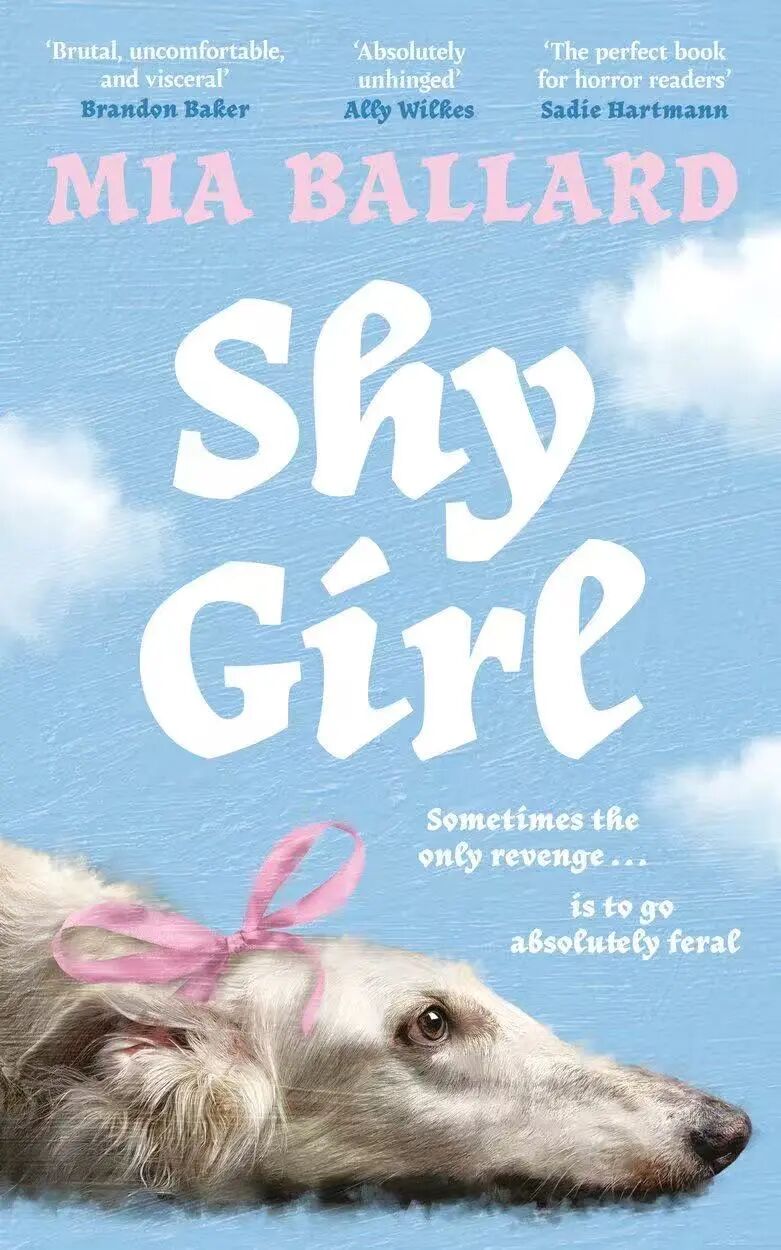
Le 19 mars 2026, le groupe d'édition Hachette a annoncé le retrait complet du roman d'horreur "Shy Girl" en raison de controverses sur le contenu généré par l'IA-, a interrompu son projet de sortie aux États-Unis et a retiré l'édition anglaise de la vente, devenant ainsi le premier grand groupe d'édition à annuler la distribution d'un livre protégé par le droit d'auteur acheté pour suspicion de création d'IA. Ce bouleversement a non seulement brisé la réputation du livre en ligne autrefois très populaire, mais a également transformé l’impact de l’IA sur l’industrie du contenu d’un risque à une réalité.
De la renommée des médias sociaux au retrait des éditeurs
Shy Girl est d'abord devenue populaire grâce aux médias sociaux, mais est finalement tombée en disgrâce face aux critiques généralisées en ligne. Shy Girl raconte l'histoire d'une jeune femme désespérée qui est emprisonnée par un homme qu'elle a rencontré en ligne et forcée de lui servir d'animal de compagnie. En février 2025, l'auteur Mia Ballard a auto-publié ce roman d'horreur. Avec son sujet et son intrigue provocateurs, le roman est devenu viral sur BookTok, recevant près de 5 000 critiques et une note de 3,52 étoiles sur Goodreads, et a ensuite été repris par le groupe d'édition Hachette. Il a été officiellement publié au Royaume-Uni en novembre 2025, avec des ventes d'impression atteignant 1 800 exemplaires, et sa sortie était initialement prévue aux États-Unis en mai 2026.
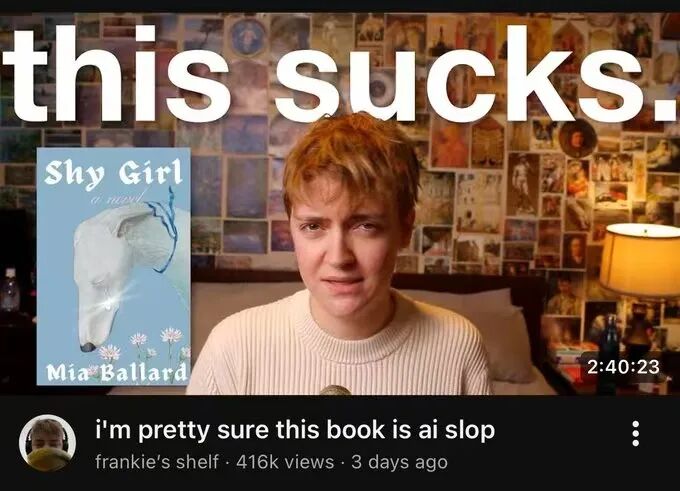
Au fur et à mesure que la portée de ce livre s'est élargie, certains lecteurs attentifs et professionnels de l'édition ont remarqué des traces de génération d'IA dans l'ouvrage. En janvier 2026, un éditeur de livre qui prétendait avoir 12 ans d'expérience a publié un long article sur Reddit, soulignant que son style d'écriture ne se distinguait pas de celui de l'écriture LLM (large Language Model), comme l'utilisation excessive d'adjectifs, les structures de phrases et d'expressions très répétitives et l'utilisation excessive de traits d'union. Peu de temps après, une vidéo d'analyse YouTube de près de trois -heures-a été publiée, avec le titre indiquant sans ambages : "Je suis presque certain que ce livre est un ouvrage mal écrit généré par l'IA-", fournissant une ventilation détaillée des fonctionnalités du roman soupçonnées d'être générées par l'IA-. La vidéo a atteint plus de 1,2 million de vues, portant la controverse à son paroxysme. Les résultats de détection professionnelle ont en outre confirmé le différend. Max Spero, fondateur et PDG de la société de détection d'IA Pangram, a déclaré après avoir testé que 78 % du contenu du livre était généré par l'IA-. De plus, les internautes ont analysé deux autres œuvres de Mia Ballard, révélant que la plupart du contenu était également généré par l'IA-. Max Spero a également commenté avec acuité : « De toute évidence, même si ce n'est pas entièrement écrit par l'IA, l'IA en a réalisé une très grande partie. » L'opinion publique s'est ensuite inversée, avec-les critiques d'une étoile augmentant rapidement sur Goodreads, accusant le livre d'être écrit par ChatGPT.
Après que le New York Times ait présenté à Hachette la preuve le 19 mars que le roman était soupçonné d'être généré par l'IA-, le roman a été retiré d'Amazon et du site officiel de Hachette cet après-midi-là. Le lendemain, la société a annoncé qu'elle annulerait les projets de publication du livre aux États-Unis et cesserait de vendre le livre au Royaume-Uni. Un porte-parole de Hachette Publishing a déclaré que la société s'engage toujours à préserver l'expression créative et la narration originales. Il a ajouté que Hachette exige que toutes les œuvres soumises soient originales par l'auteur et implore les auteurs de divulguer à l'entreprise s'ils utilisent des outils d'intelligence artificielle dans le processus d'écriture.
Mais Mia Ballard a fermement nié l'utilisation de l'IA dans un e-mail envoyé au New York Times jeudi soir, accusant l'éditeur qui a géré la version auto-publiée de tous les problèmes, affirmant que l'éditeur avait utilisé l'IA sans autorisation dans son travail, et a déclaré sans ambages qu'"une telle controverse a ruiné ma réputation et mon état mental a touché le fond", et a déclaré qu'une action en justice avait été engagée contre l'éditeur. Cependant, cette déclaration n'a pas été reconnue par l'industrie et les internautes, et Thad McIlroy, consultant dans l'industrie de l'édition, a déclaré sans détour : « Cet incident confirme les risques de l'IA que l'industrie prédit depuis longtemps, et l'impact de l'IA sur l'industrie de l'édition est passé de la théorie à la réalité. "
L'impact de cet incident va bien au-delà de la suppression d'un livre, pour lequel Hachette a investi en amont, en ressources éditoriales, en planification marketing et en conception de couverture pour "Shy Girl" avant de décider de retirer le livre. Même si ces coûts irrécupérables ont été engagés, les éditeurs estiment toujours que les conséquences de la poursuite de la publication sont plus graves que la perte de ces coûts. Cette décision reflète l'accent mis par l'éditeur sur la confiance des lecteurs et de la communauté des auteurs, ainsi que sur la réputation à long terme de la marque. Dans un marché du livre axé sur la confiance, les dommages potentiels liés à la publication d'un roman soupçonné d'être généré par l'IA- dépassent de loin la perte financière à court terme - liée à l'annulation de la distribution.
Le nœud de l’industrie derrière la tourmente
La suppression de « Shy Girl » n’est pas un cas isolé et, dans le contexte d’une industrie à forte pénétration de l’IA, le cœur de l’industrie de l’édition a été révélé très tôt. Depuis l’avènement de ChatGPT en 2022, divers outils d’IA générative ont continué à itérer et sont devenus de nouveaux outils de production de contenu. Les plates-formes d'auto-édition telles que Amazon Kindle Direct Publishing sont devenues les domaines de contenu d'IA les plus durement touchés. Avec des seuils de publication faibles pour les plates-formes d'auto-édition, le contenu généré par l'IA peut être rapidement écrit et mis en rayon ici, et un grand nombre d'œuvres générées par l'IA telles que des ouvrages de science-fiction, des ouvrages de référence pratiques et des livres pour enfants ont été mis sur les étagères, faisant tomber l'industrie du contenu dans le dilemme « à haut rendement et à faible rendement ». qualité" et l'homogénéisation des contenus. Plus important encore, les politiques de gestion de ces plates-formes pour le contenu généré par l'IA-sont ambiguës, ce qui entraîne un afflux important de contenu généré par l'IA-assisté ou purement par l'IA-, faisant des plates-formes d'auto-édition-un tremplin pour que le texte de l'IA soit réinjecté dans l'édition traditionnelle. Ces dernières années, afin de réduire le risque de sélection de sujets et d'exploiter le potentiel du marché, les institutions d'édition traditionnelles ont tendance à filtrer les œuvres qui ont été vérifiées par le marché à partir des plateformes d'auto-édition-, et les éditeurs américains apportent rarement des modifications significatives aux œuvres auto-éditées-acquises, ce qui présente également des dangers cachés pour le secteur de l'édition.
Cet incident a mis en évidence le manque de censure du contenu dans l'édition traditionnelle. La publication traditionnelle repose sur l'expérience subjective des éditeurs, qui ne parviennent souvent pas à faire la distinction entre le texte écrit par des humains et celui écrit par l'IA, en particulier ceux qui conservent le contenu original mais ont été traités par l'IA. En tant que groupe d'édition leader avec une histoire de 200 ans, Hachette dispose d'une équipe éditoriale professionnelle et d'un processus de révision mature, mais il n'a toujours pas réussi à identifier les traces de l'IA dans « Shy Girl » au cours de plusieurs cycles de révision. De plus, le double problème des « faux positifs » et des « faux négatifs » des outils de détection d'IA introduits dans l'industrie est important, et le détecteur de texte lancé par OpenAI a été retiré des étagères en raison de sa faible précision, et il n'existe actuellement aucune norme technique unifiée pouvant fournir des données de détection fiables pour l'industrie de l'édition. L'échec de l'examen manuel et la détection technique peu fiable ont placé le secteur de l'édition dans une situation embarrassante où il ne peut pas identifier avec précision le contenu généré par l'IA-.
Le problème fondamental exposé par des incidents similaires est principalement le décalage des règles industrielles et des systèmes juridiques. La plupart des contrats de publication stipulent uniquement le plagiat et la propriété des droits, et ne définissent pas clairement la propriété du contenu généré par l'IA-, ni ne précisent le degré d'utilisation de l'IA dans le processus de création ni s'il doit être divulgué. Au niveau juridique, bien que le plan de travail législatif du Conseil d'État pour 2025 propose de « promouvoir le travail législatif visant à promouvoir le développement sain de l'intelligence artificielle », des lois spéciales n'ont pas encore été promulguées et des questions clés telles que la propriété des droits d'auteur sur le contenu généré par l'IA-et les jugements pour violation de l'utilisation de l'IA manquent de base juridique.
L'IA n'est pas le péché originel
La suppression de Shy Girl ne signifie pas que l’industrie de l’édition ou même l’industrie du contenu devraient rejeter la technologie de l’IA.
Il n’y a ni bien ni mal dans la technologie, et la clé réside dans la façon dont les créateurs et les éditeurs de contenu planifient les limites d’utilisation. La valeur de l'IA générative pour l'édition est reconnue depuis longtemps par l'industrie, et son application dans le tri des documents, la sélection des sujets, la relecture des manuscrits, la conception de la composition et d'autres liens a considérablement optimisé le processus de production de contenu et amélioré l'efficacité de la publication, ce qui est également l'intention initiale de l'industrie d'explorer le modèle de création d'intégration homme-machine. Les éditeurs devraient assumer la responsabilité de gardiens dans le processus d’autonomisation technologique, afin que l’IA puisse devenir un outil auxiliaire plutôt qu’un sujet créatif. L’IA est peut-être capable de suivre la logique du texte, mais la création humaine combine la logique du texte et la logique émotionnelle, et ses pensées et ses températures sont difficiles à simuler pour l’IA. En tant que gardiens du contenu, les éditeurs jouent un rôle dans la sélection du contenu, le traitement approfondi et le contrôle de la valeur, difficile à remplacer par l’IA.
Pour cette raison, face à l’impact de la technologie de l’IA, le secteur de l’édition a commencé à essayer d’améliorer activement les normes. Penguin Random House, Simon & Schuster et HarperCollins ont tous mis à jour leurs directives de soumission au cours des derniers mois pour traiter le contenu généré par l'IA-, et des agences littéraires telles que Greene & Heaton et Eve White Literary Agency ont ajouté des clauses à leurs directives de soumission, exhortant les auteurs à ne pas utiliser l'IA dans leurs documents de soumission. Peut-être que la décision de Hachette accélérera le processus d'élaboration des politiques-à l'échelle du secteur.
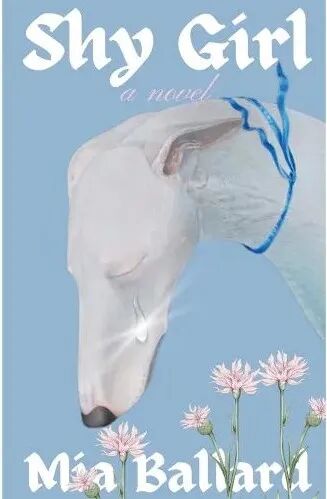
La suppression de "Shy Girl" représente un revers pour le secteur de l'édition à l'ère de l'IA, mais elle oblige également le secteur à affronter les problèmes de front-, en faisant passer les discussions sur l'intelligence artificielle des discours théoriques aux contrats concrets et aux formulations juridiques. Son impact imprégnera progressivement tous les aspects des négociations sur les droits d’auteur, des discussions contractuelles et de la mise en place de systèmes éditoriaux. À l’heure actuelle, de nombreux professionnels de l’édition ont également commencé à appeler activement le gouvernement national à accélérer le processus législatif sur l’intelligence artificielle, en fixant des limites juridiques claires pour les applications de l’IA dans l’édition. Les éditeurs doivent de toute urgence développer des méthodes fiables de détection de contenu IA, établir des règles claires pour divulguer l'utilisation de l'IA et améliorer les clauses-concernant l'IA dans les contrats, afin que les pratiques du secteur soient soumises à des réglementations. Pour les auteurs, le secteur de l'édition n'est pas encore prêt à accepter pleinement le contenu généré par l'IA-, et la divulgation d'informations pendant le processus de création deviendra l'une des exigences des futures collaborations en matière d'édition.
Un problème encore plus important est que, la technologie de détection de l'IA étant encore imparfaite et reposant actuellement uniquement sur le sérieux des auteurs, la question de savoir si les éditeurs peuvent réellement mettre en œuvre de nouvelles normes et si les litiges découlant du contenu généré par l'IA-continueront à se produire à l'avenir, restent une épée de Damoclès qui pèse sur le secteur de l'édition.