


Ne laissez pas la prépression des workflows vous ralentir! Notre auto - a développé des outils augmentant l'efficacité de près de 10 fois
Contexte de développement: originaire des besoins de production réels
Le traitement du document pré-presse pour l'impression numérique prend trop de temps. Après avoir communiqué avec les opérateurs de première ligne, trois exigences de base ont été identifiées et confirmées.
(1) Vérification par lots Numéros de page du document: Dans l'impression et la composition, il est souvent nécessaire de s'assurer que les numéros de page de document sont égaux, sinon cela peut entraîner un gaspillage de matériaux d'impression ou d'erreurs de liaison.
(2) Traiter automatiquement les documents de page impair: Pour les documents avec des pages impairs, une page vierge doit être ajoutée uniformément à la fin, tandis que les documents avec des pages pair doivent rester inchangés.
(3) Vérification par lots pour l'inflexion du texte: Pour éviter les erreurs d'impression causées par des polices manquantes, il est nécessaire de confirmer si le texte du document a été converti en courbes (c'est-à-dire "inflexion").
Grâce à des recherches sur Adobe Acrobat et divers plugins de traitement PDF sur le marché, il a été constaté que les outils existants ont des fonctions redondantes et complexes, ou ne correspondent pas au processus de production réel de l'entreprise, en particulier en termes de risques de sécurité dans la conversion de fichiers. Plus important encore, des outils similaires produits au niveau national nécessitent souvent un paiement, ce qui entraîne des coûts d'utilisation des termes longs plus élevés -. Sur la base des problèmes pratiques susmentionnés, la société a décidé de développer un outil spécialisé léger, précis et compatible en interne.
Outil de vérification et de traitement de la page PDF
01
Fonctions de base et logique de jugement
L'objectif principal de cet outil est de s'assurer que toutes les pages du document à imprimer sont uniformes, et que son approche de jugement et d'exécution est la suivante.
(1) Mécanisme de détection de page: Lisez les métadonnées des documents PDF via la bibliothèque PYMUPDF pour obtenir directement les informations de la page totale.
(2) Logique du jugement de parité: utilisez le fonctionnement du modulo (numéro de page% 2) pour déterminer la parité. Si le résultat est 1, il est jugé comme une page impair, et si le résultat est 0, il est jugé comme une page pair.
(3) stratégie de traitement de différenciation: s'il s'agit d'un document numéroté impair, ajoutez automatiquement une page vierge de la même taille que le document d'origine à la fin du document; S'il s'agit d'un document de page pair, gardez le contenu inchangé et copiez-le directement dans le répertoire de sortie.
(4) Principe de traitement de la sécurité: tous les documents traités sont enregistrés dans le répertoire désigné "Fichiers traités", et les fichiers d'origine restent inchangés pour éviter les dommages causés par les fichiers causés par la mauvaise opération, comme le montre la figure 1.
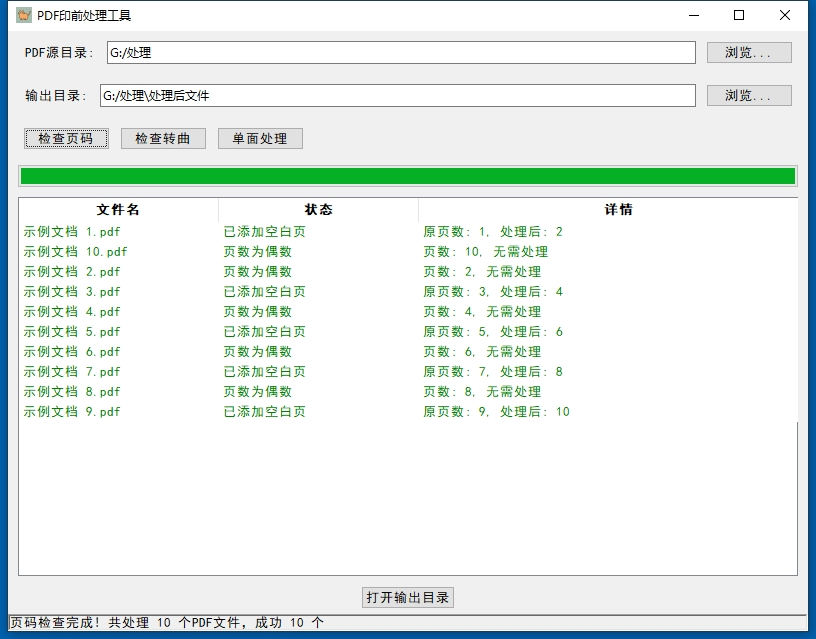 Figure 1 Interface de vérification et de traitement de la page PDF
02
Points clés de la mise en œuvre technique
L'outil utilise Tkinter pour créer une interface graphique, qui comprend principalement trois modules fonctionnels.
(1) Module de sélection du répertoire: prend en charge la sélection visuelle des répertoires de fichiers source et des répertoires de sortie, le répertoire de sortie par défaut étant un sous-dossier dans le répertoire source.
(2) Module de traitement par lots: Utilisation de la technologie Thread Multi - pour implémenter le traitement du backend, éviter le décalage d'interface et afficher les progrès de traitement dans le temps réel - via une barre de progression.
(3) Module d'affichage des résultats: présenter les résultats de traitement de chaque fichier dans un format de table, y compris le numéro de page d'origine, les actions de traitement et les informations d'état, et distinguer les états réussis et défaillants par couleur.
Outil de vérification de la conversion PDF
01
Fonctions de base et logique de jugement
L'outil de vérification de la courbe se concentre sur la détermination si le texte du document a été converti en courbe, et sa logique de jugement de base est basée sur l'analyse des informations de police dans les documents PDF.
(1) Détection de présence de texte: En utilisant la fonction d'extraction de texte de la page, déterminez si le document contient du texte modifiable.
(2) Analyse des informations sur les polices: analyser la liste des polices intégrées dans le document. S'il y a des informations de police, cela indique que le texte n'a pas été converti.
(3) Règle complète du jugement: s'il y a du contenu texte mais aucune information de police, cela indique que la chanson a été convertie (marquée en vert); Aucun contenu texte, indiquant pas besoin de changer de pistes (étiquette verte); S'il y a du contenu texte et des informations de police, cela indique que la chanson n'a pas été convertie (marquée en rouge), comme le montre la figure 2.
L'outil est spécialement conçu pour le mode "vérifier uniquement sans conversion", principalement parce que selon les commentaires des opérateurs, lors de l'exécution de l'opération de conversion sur des fichiers contenant des scellés officiels, il est facile de provoquer la perte de joints officiels et d'autres modèles. Par conséquent, seule la fonction de contrôle est conservée.
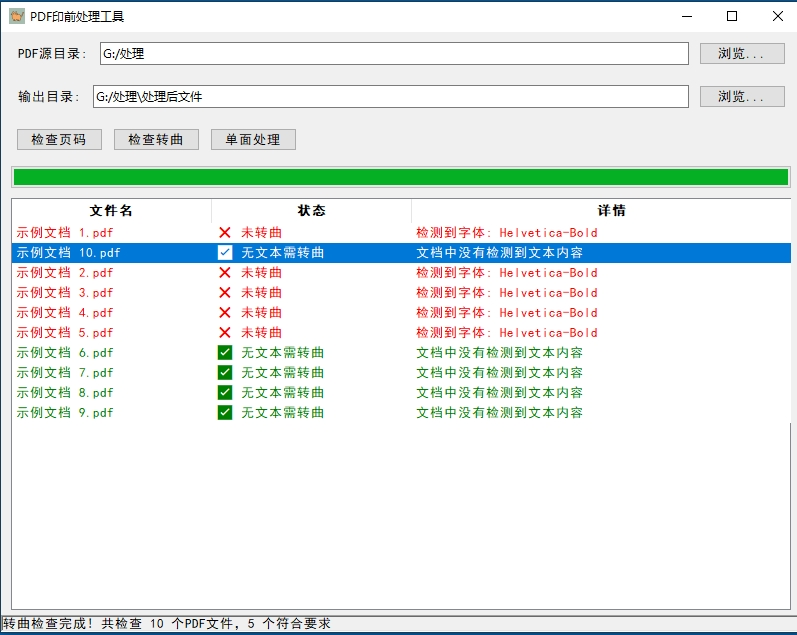 Figure 2 outil de vérification de conversion PDF
02
Points clés de la mise en œuvre technique
Cet outil utilise également Tkinter pour construire l'interface, et les points techniques clés incluent les trois points suivants.
(1) Extraction des informations de police: à l'aide de la fonction d'analyse de blocs de texte de PYMUPDF, obtenez les noms et occurrences de toutes les polices utilisées dans le document.
(2) Visualisation des résultats: utilisez une vue d'arbre pour afficher les résultats d'inspection et distinguer visuellement différents états à travers les couleurs et les icônes.
(3) Fonction des statistiques d'état: calculer automatiquement le nombre de fichiers qui répondent aux exigences, en aidant les opérateurs à saisir rapidement la situation d'inspection globale.
Difficultés et solutions dans le processus de développement
En tant que développeur non professionnel, j'ai rencontré de nombreux défis techniques pendant le processus de développement des outils. Les problèmes et solutions spécifiques sont les suivants.
(1) Problème de profondeur d'analyse PDF: La bibliothèque PDF initiale utilisée n'a pas pu extraire avec précision les informations de police. Après la recommandation de l'IA, il a été résolu en le remplaçant par la bibliothèque PYMUPDF.
(2) Problème de retard de l'interface: Lors du traitement d'un grand nombre de fichiers en vrac, l'interface est sujette à des états non réactifs. Avec le guidage de l'IA, une solution de traitement filetée multi - a été implémentée pour résoudre efficacement ce problème.
(3) Chinois Afficher les caractères brouillés: En configurant les paramètres de police et les paramètres de codage, le problème de l'affichage chinois affiche des caractères brouillés dans l'interface et les fichiers exportés ont été résolus.
(4) Mécanisme de gestion des exceptions: En réponse au problème des accidents du programme causés par des fichiers PDF endommagés, un mécanisme de capture d'exception a été amélioré pour garantir que la défaillance du traitement de fichiers individuel n'affecte pas le processus global.
Tout au long du processus de développement, les outils d'IA ont joué un rôle important en tant que consultants techniques, fournissant non seulement des exemples de code clés, mais également expliquant les principes de l'analyse du format de fichiers PDF, aidant les développeurs à comprendre rapidement les connaissances professionnelles du domaine.
La valeur et la perspective de l'application d'outils
L'application de ces deux outils a apporté des améliorations d'efficacité importantes aux travaux de production, qui se reflètent dans les deux aspects suivants.
(1) Économies de coûts de temps: les travaux d'inspection manuels qui nécessitaient à l'origine 1 heure peuvent désormais être achevés en 5 minutes, ce qui augmente l'efficacité de près de 10 fois.
(2) Amélioration de la stabilité de la qualité: éviter efficacement les omissions d'inspection manuelle et assurer une qualité d'impression stable.
L'enregistrement du processus de développement de ces deux petits outils vise à transmettre la philosophie de travail de «l'exploration et de l'innovation», de se concentrer sur la résolution de problèmes spécifiques dans la production réelle, d'optimiser les flux de travail traditionnels par des moyens technologiques et, finalement, d'atteindre l'objectif de réduction des coûts et d'amélioration de l'efficacité.